Criação com IA
Como manter o mesmo rosto em várias imagens com IA
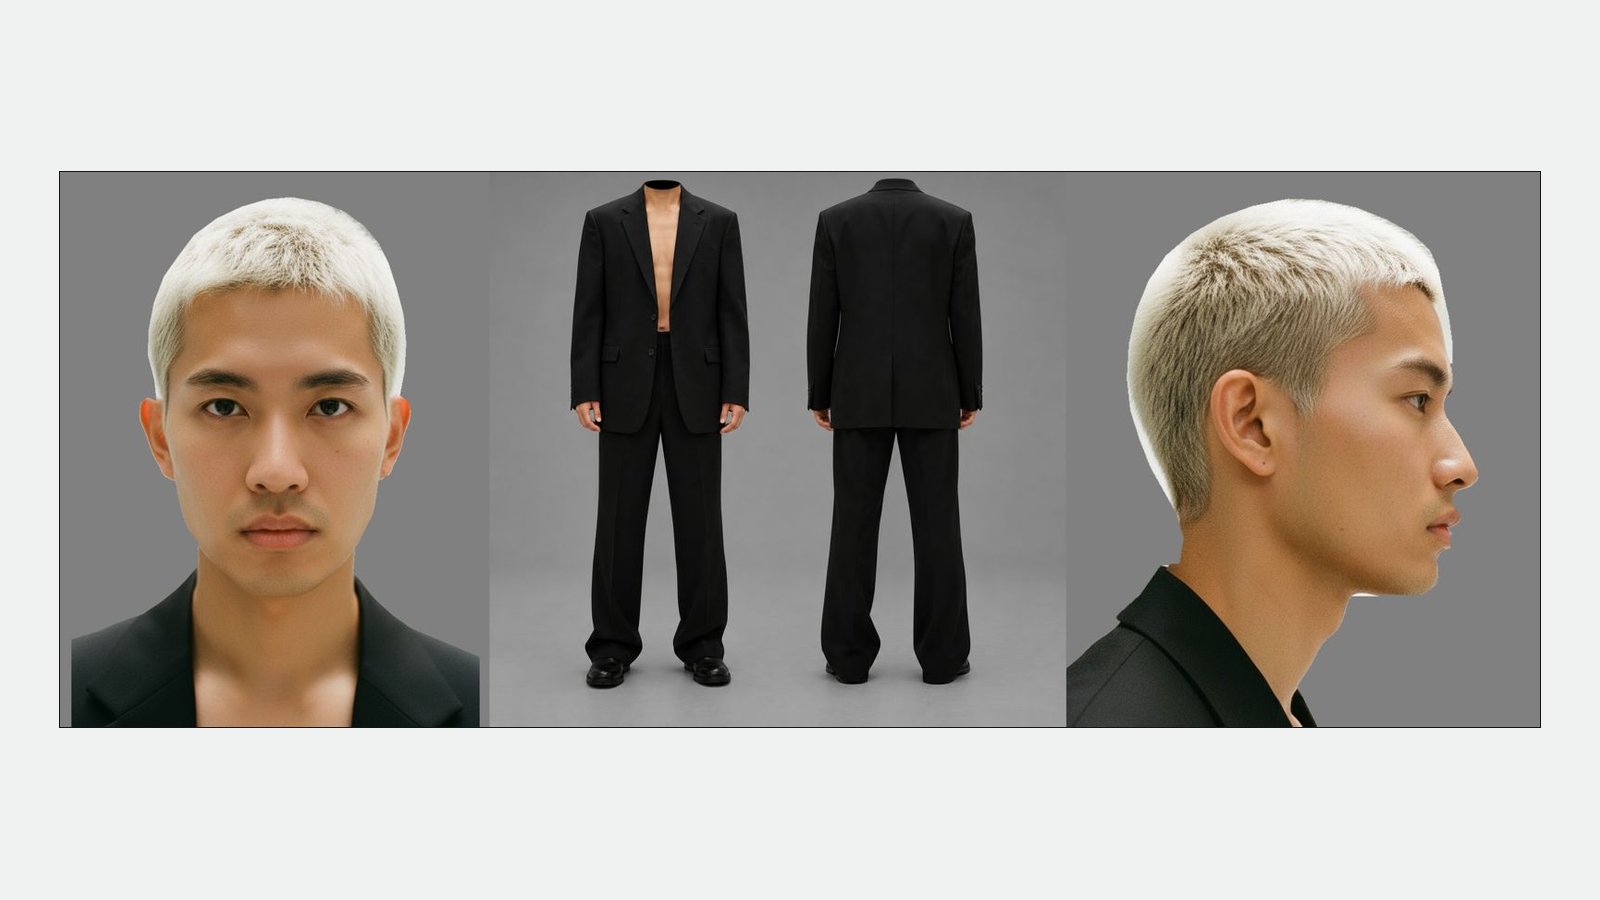
Trave a identidade antes da primeira cena. Monte uma prancha de referência com o rosto de frente, em três quartos e de perfil, use essa prancha em todas as gerações e escreva no prompt o que não pode mudar: traços, cabelo, tom e textura da pele. Cenário, luz, câmera e figurino podem variar à vontade. Quando a IA errar um detalhe, corrija só aquele ponto em vez de gerar a imagem inteira de novo.
Consistência de rosto é a primeira pergunta que uma marca faz antes de confiar numa campanha feita com IA: a modelo continua sendo a mesma pessoa de uma foto para outra? Se ela vira outra pessoa no terceiro post, a campanha acaba ali.
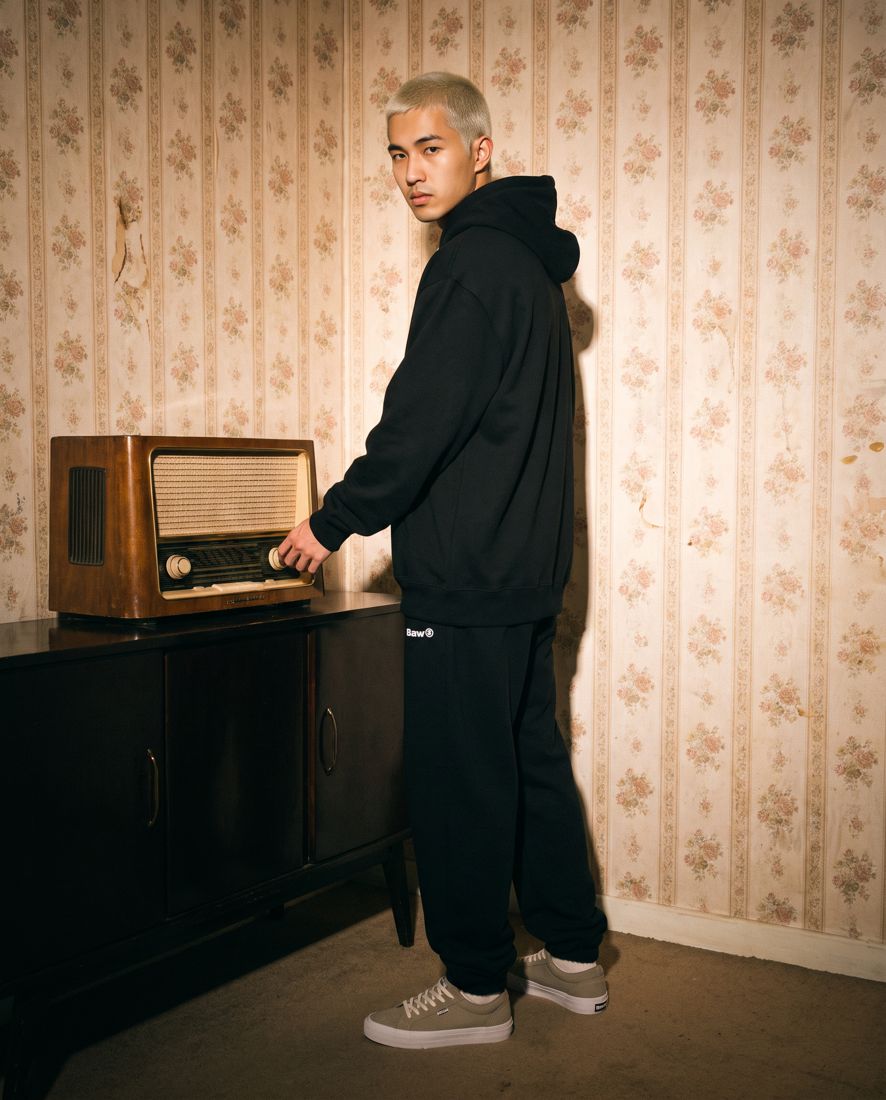
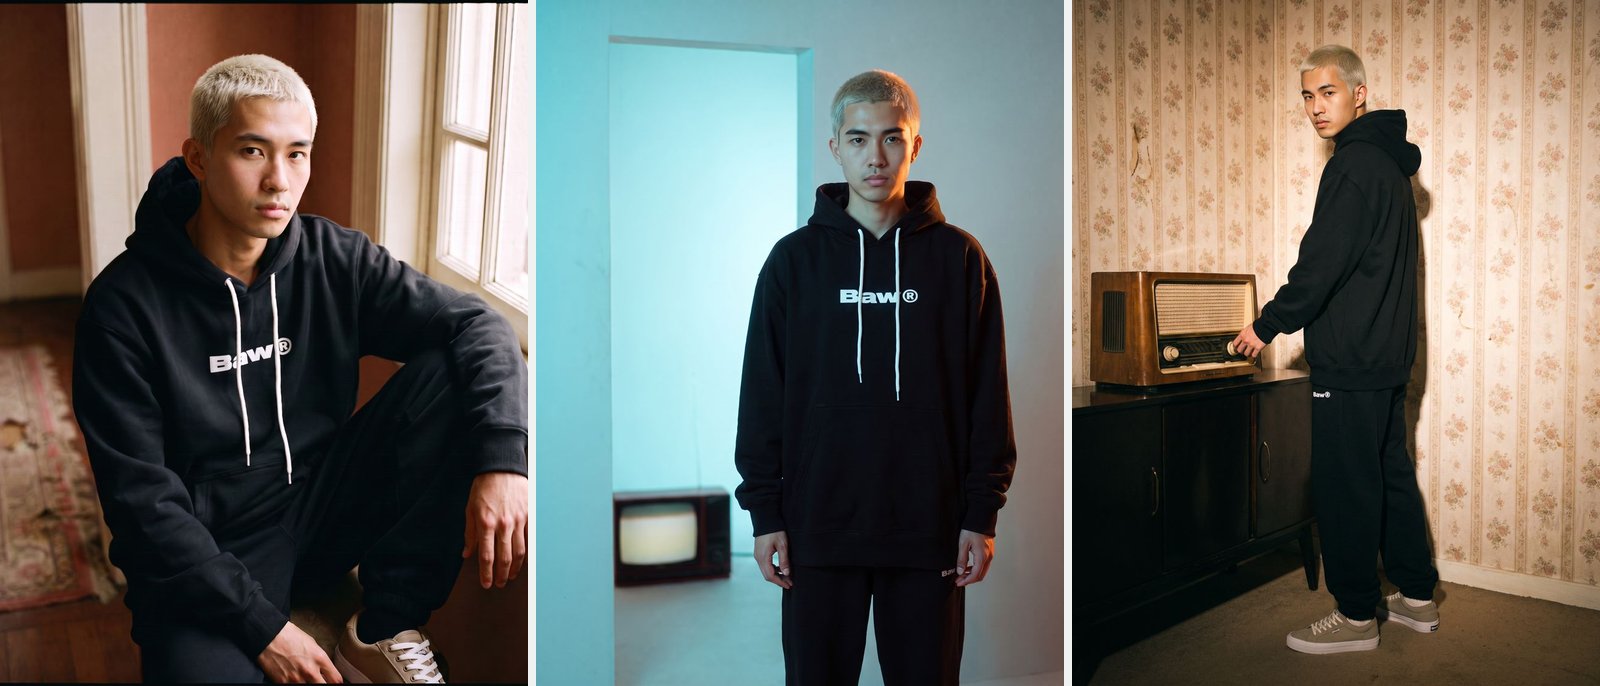
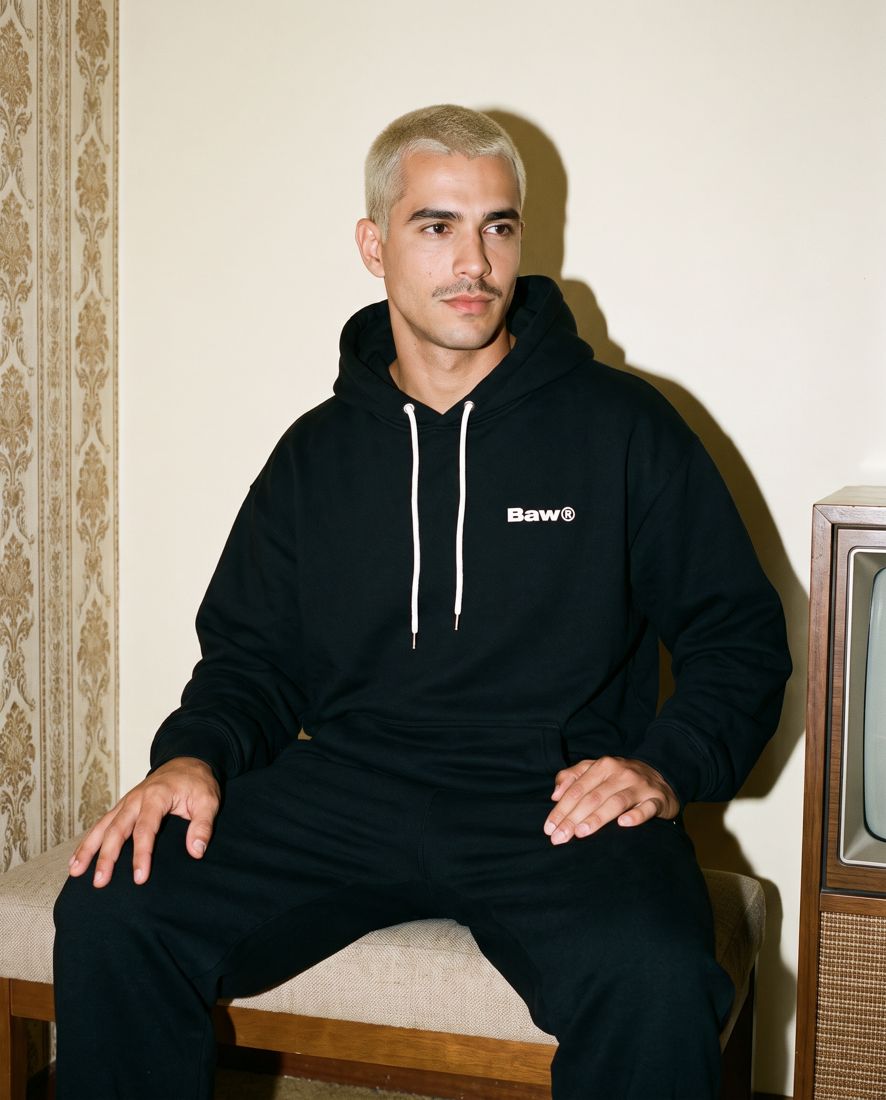
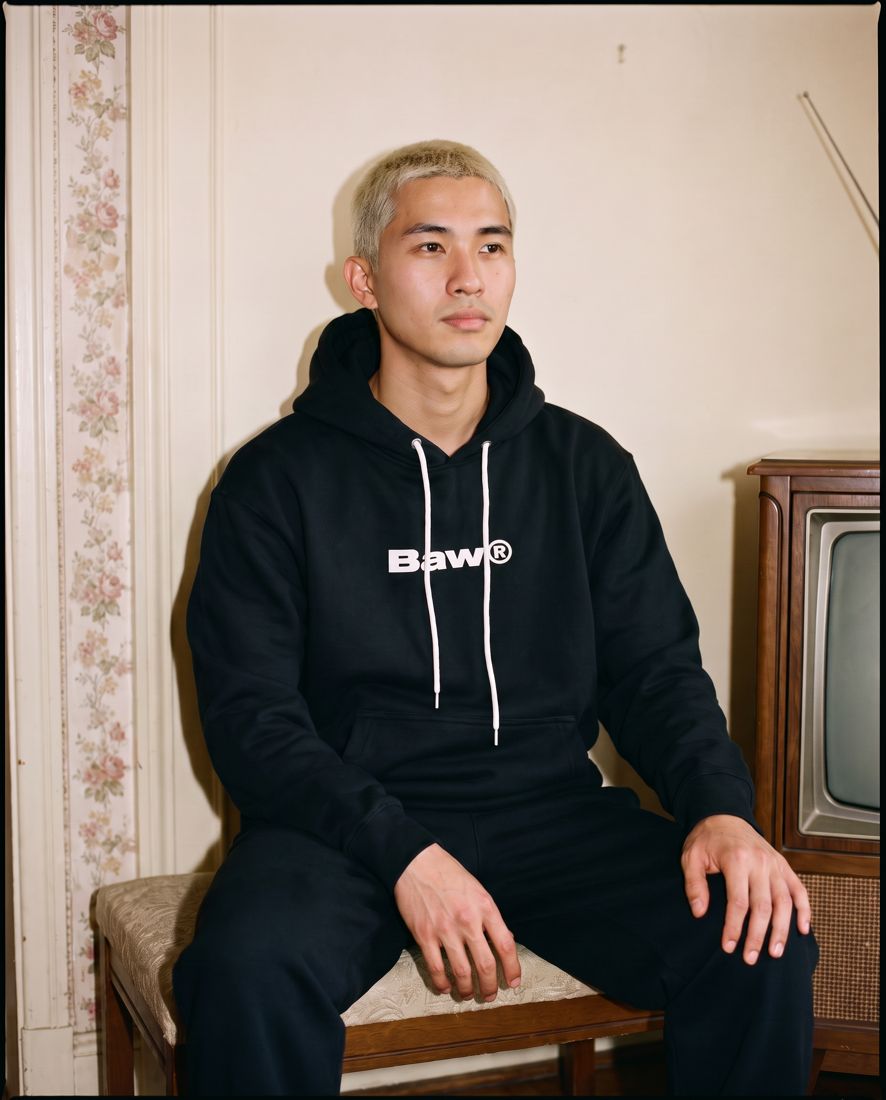
Fiz três ensaios em que esse era o problema principal. No Baw®, dez retratos do mesmo modelo, com o mesmo moletom, em dez salas diferentes. No Um retrato, sete sets, sete cenários a partir de uma única foto de estúdio. No 90s Nostalgia, um grupo de personagens recombinado em várias poses. Este texto junta o que funcionou e o que deu errado nos três.
Por que a IA muda o rosto de uma imagem para outra?
Porque cada geração é uma imagem nova. A ferramenta não guarda a pessoa que criou antes: ela lê a referência e o texto de novo a cada pedido, e qualquer brecha vira variação. Se o prompt fala muito da cena e pouco da pessoa, a cena ganha.
Os próprios fabricantes admitem o limite. Ao lançar o modelo de imagem do Gemini em 2025, o Google listou a consistência de personagem entre as limitações atuais: o modelo é bom nisso, mas nem sempre acerta. Na documentação do Midjourney, o aviso é parecido: detalhes finos, como sardas ou um logo na roupa, podem não sair iguais.
Na pesquisa acadêmica, o problema tem nome: geração orientada por sujeito. O DreamBooth, do Google Research (2022), foi um dos primeiros trabalhos a mostrar como ensinar um modelo a reconhecer uma pessoa ou objeto específico a partir de poucas fotos. As ferramentas de hoje resolvem boa parte disso com imagens de referência, sem treinar nada.
O que é um character sheet e como montar um?
É uma prancha de referência da pessoa, como as que se usam em animação. No Baw®, antes da primeira cena, o modelo foi gerado e virou um character sheet com rosto de frente, em três quartos e de perfil, e corpo de frente, em três quartos e de costas.
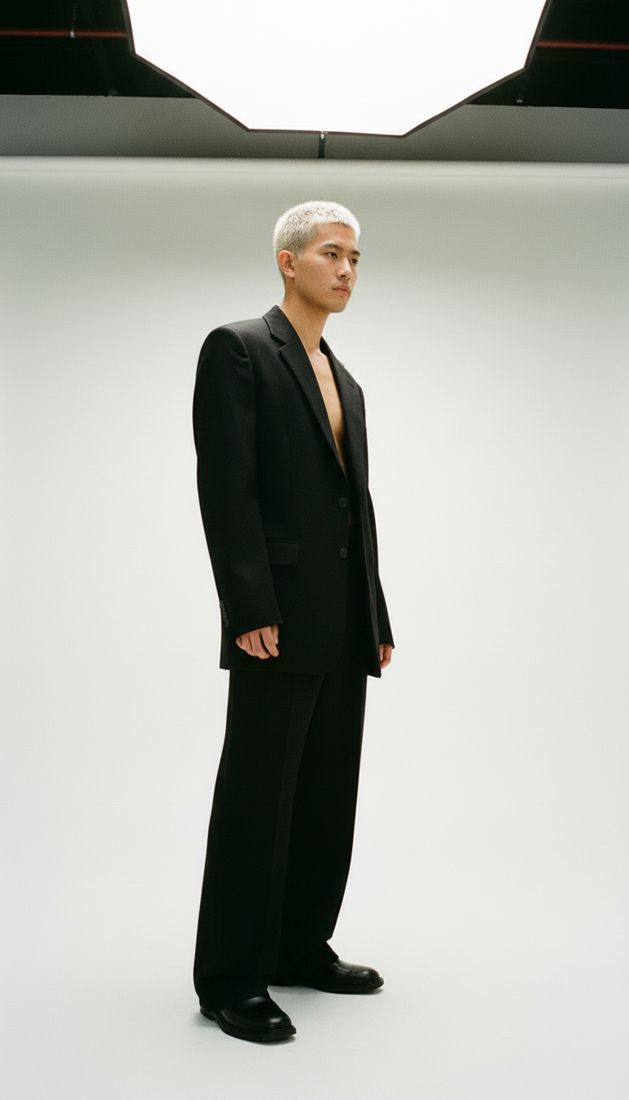
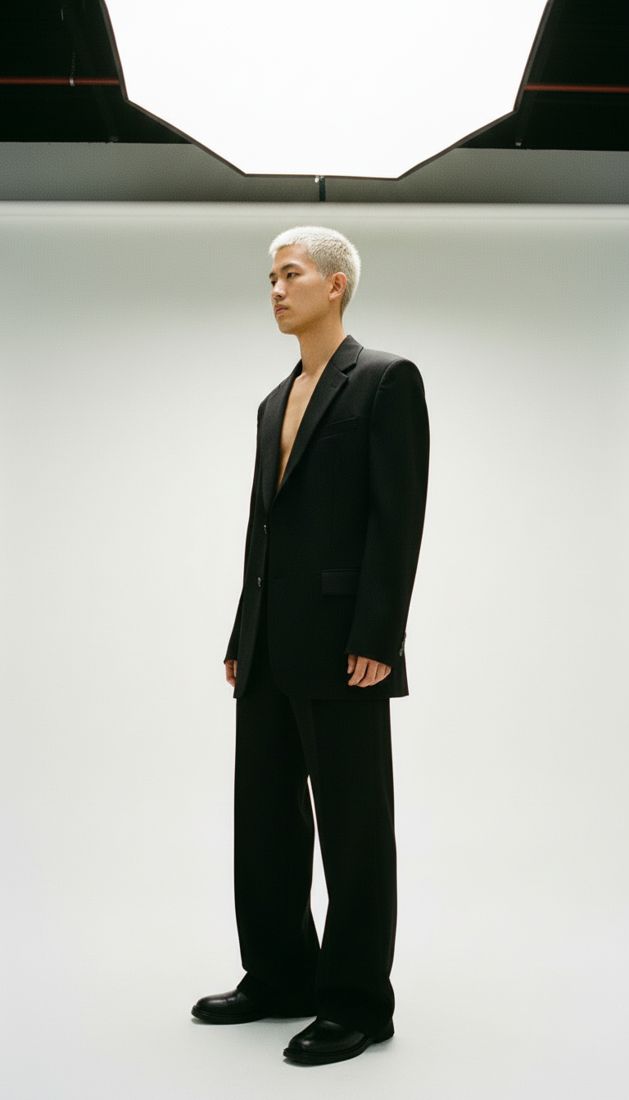
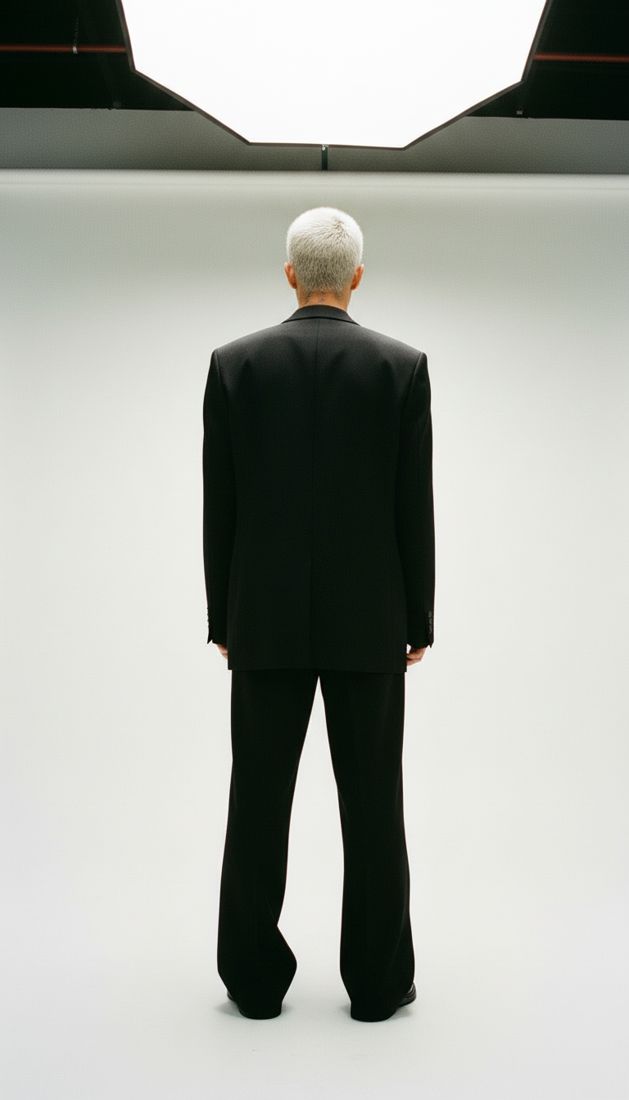
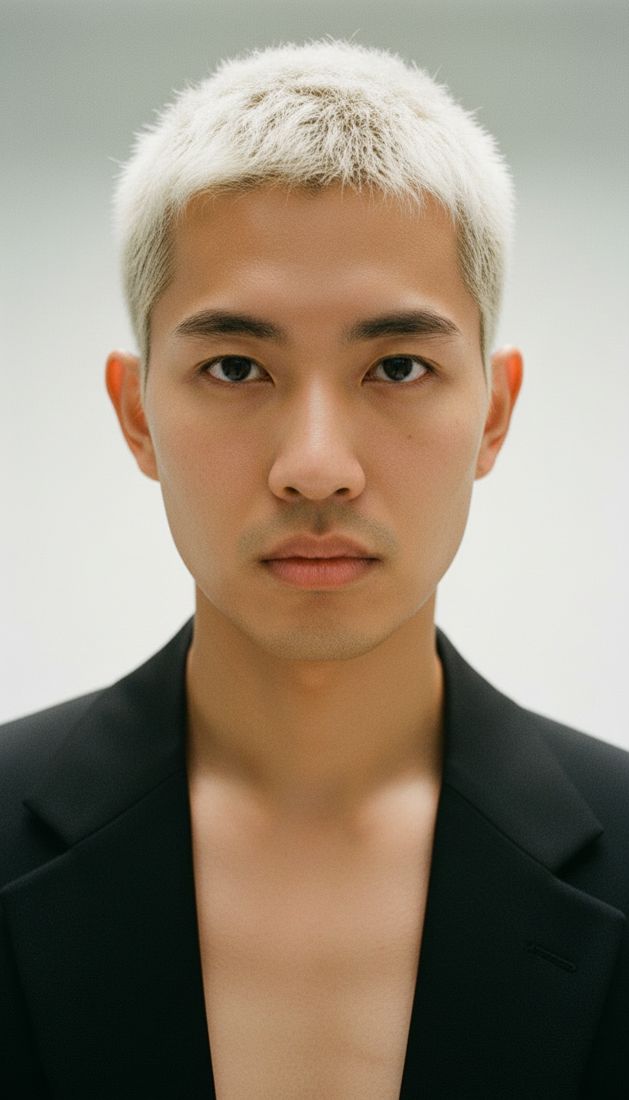
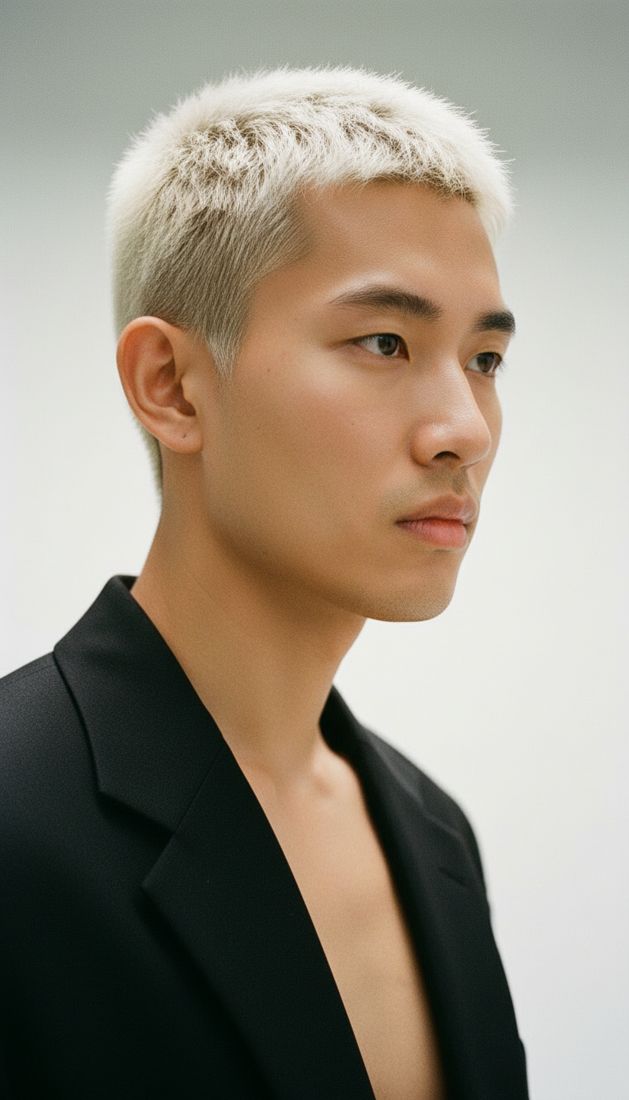
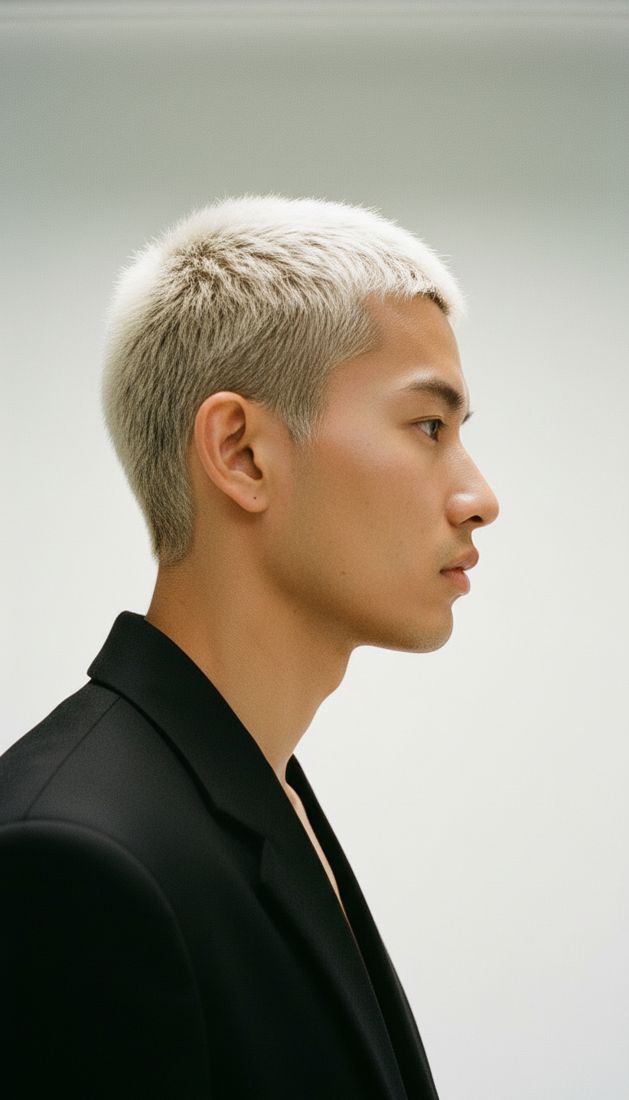
O ponto mais importante: cada prancha manda numa coisa só. O character sheet mandava no rosto. Um segundo arquivo, o product sheet, era a única fonte de figurino. Toda geração recebia as duas, e o prompt dizia para ignorar o terno que aparecia no character sheet.
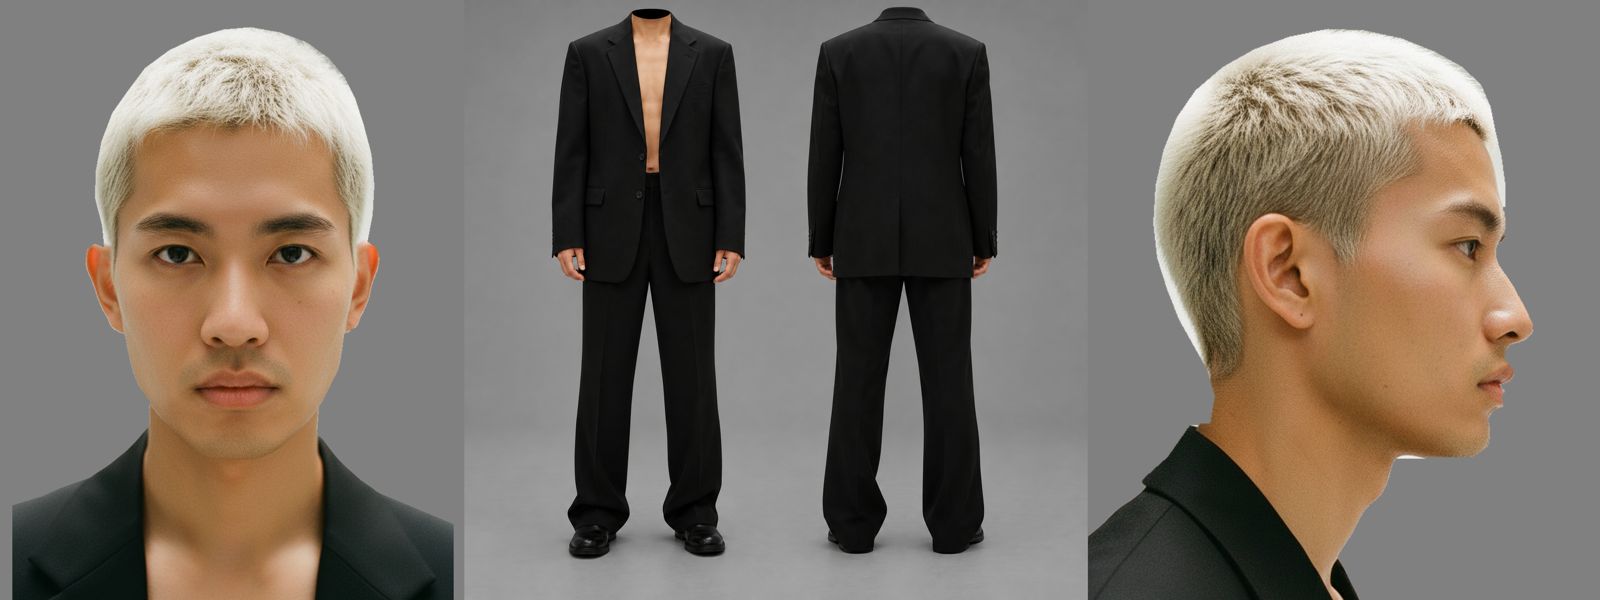
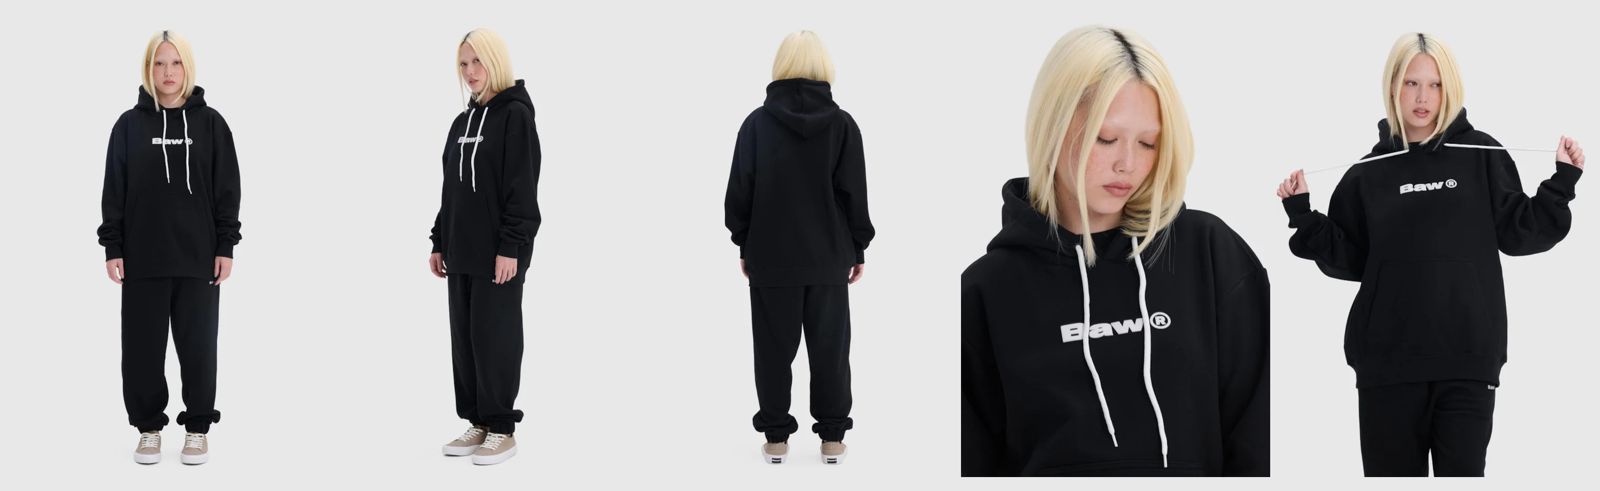
O Google recomenda algo parecido no guia de uso do Gemini: definir bem o personagem, com detalhes específicos, antes de levá-lo para outros contextos.
Uma foto só basta?
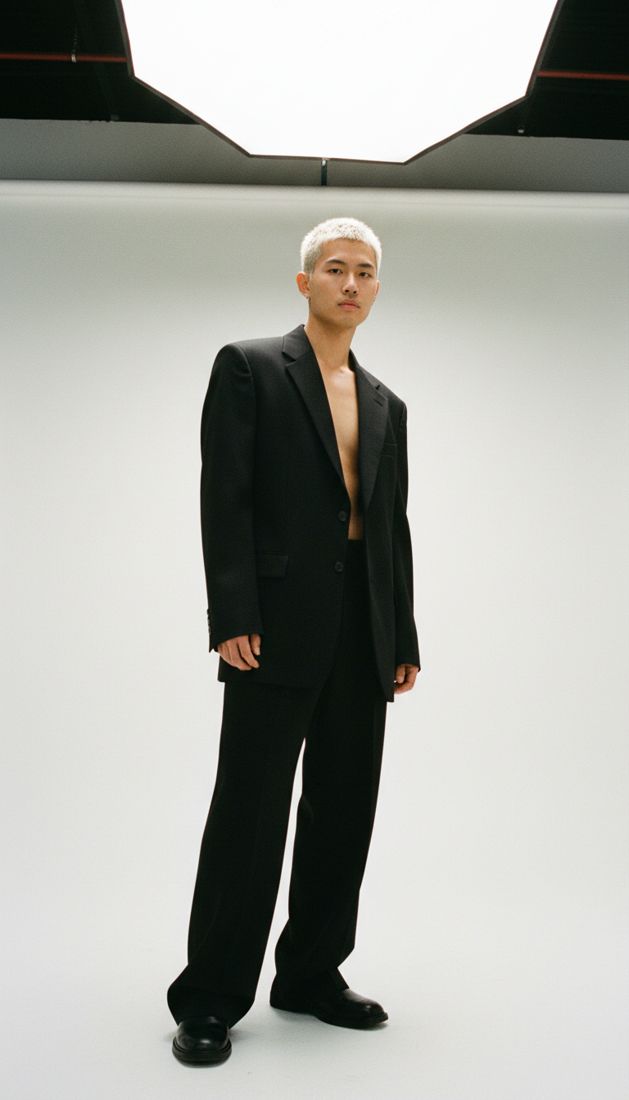
Pode bastar. No Um retrato, sete sets, o ponto de partida foi um único retrato de estúdio, e as sete cenas saíram certas na primeira geração, sem nenhuma imagem reprovada.
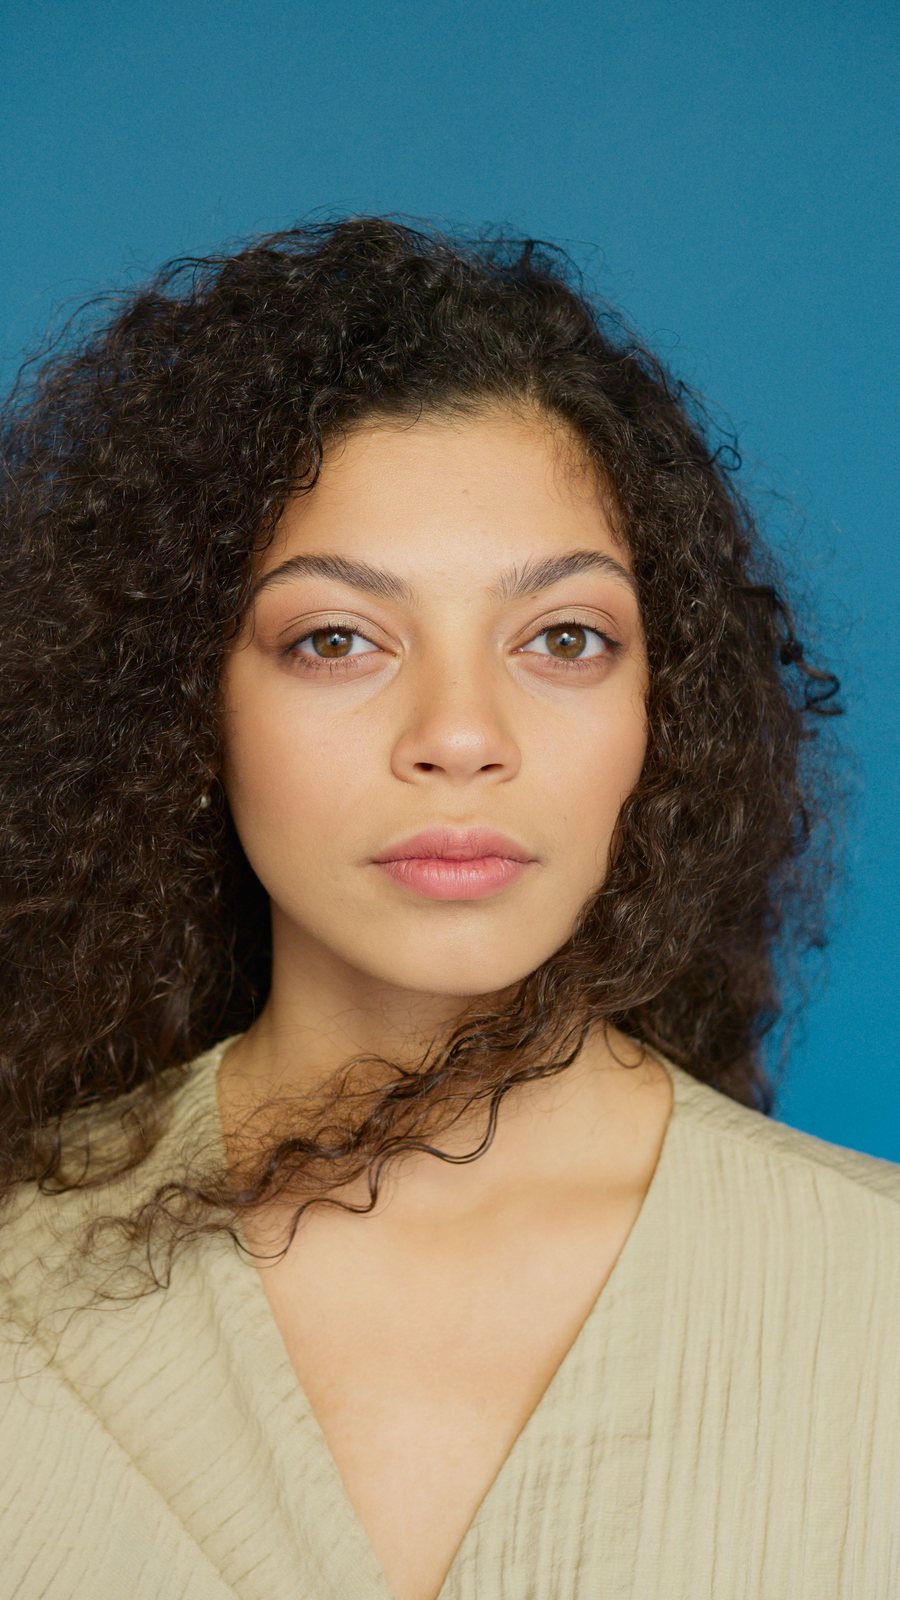
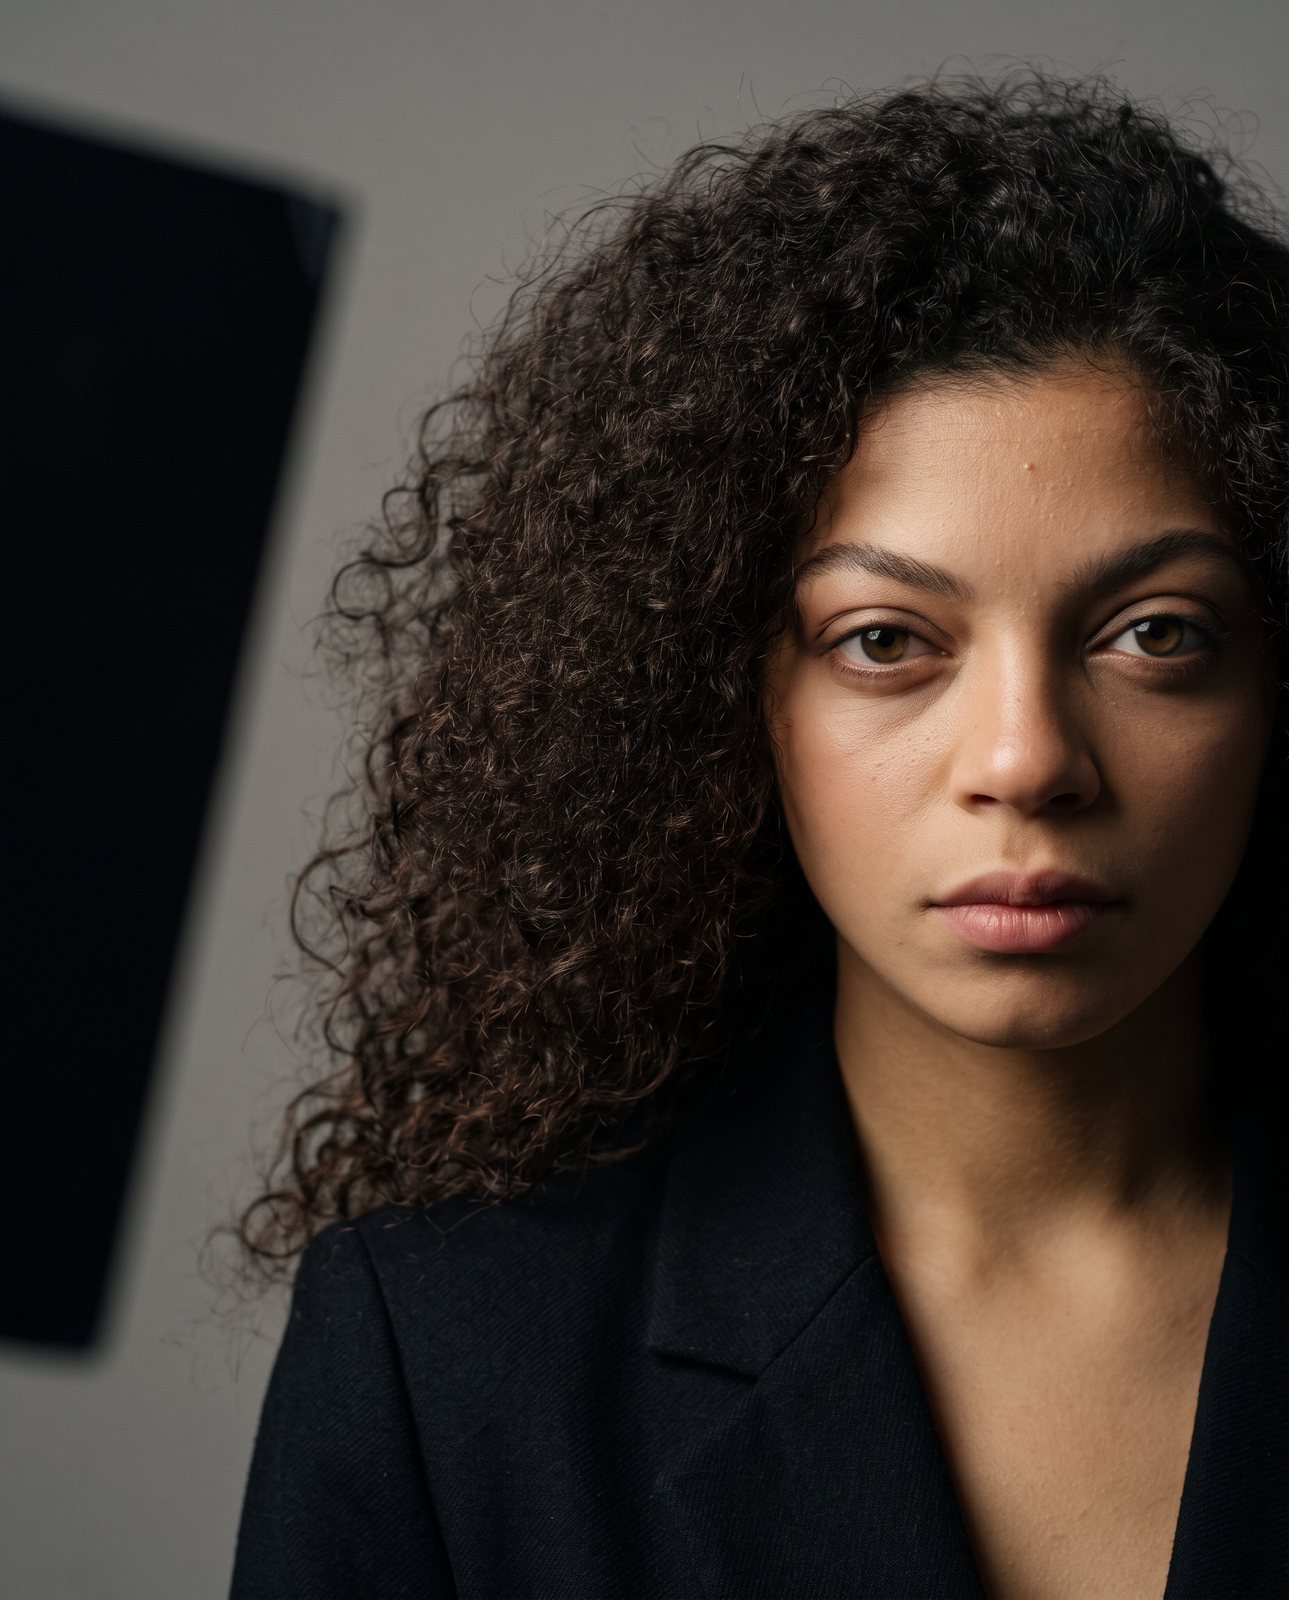
O retrato de origem é de Artem Podrez, publicado no Pexels. Todas as outras imagens foram geradas por IA, num exercício sem uso comercial.
Num teste tão inicial, isso diz menos sobre sorte e mais sobre o briefing. Cada cena tinha uma ficha de set escrita antes de gerar. Quando a ficha resolve câmera, luz e pele, sobra pouco para a ferramenta inventar.
O Midjourney, por outro lado, avisa que fotos de pessoas reais costumam não sair idênticas quando usadas como referência de personagem, e que funciona melhor com personagens gerados por ele mesmo. A ferramenta muda o quanto uma foto só aguenta.
O que deve mudar e o que deve ficar?
Trave o rosto e solte todo o resto. Nas sete cenas do Um retrato, sete sets, mudaram câmera, lente, altura, ângulo, luz, emulação de filme, figurino, pose e cenário: duas câmeras, quatro lentes e três filmes ao todo. Ficaram fixos o rosto, o cabelo, o tom de pele e a descrição física da pele.
Quanto mais a gramática da foto muda, mais fica claro que quem segura o ensaio é a pessoa. Se tudo muda junto, o rosto vai junto.
Por que descrever a pele ajuda a manter o rosto?
Porque pele de gente é o que separa um ensaio de um catálogo de avatar. Em todas as fichas repeti a mesma descrição: poros visíveis, oleosidade natural, sobrancelha sem pó, nada de suavização. Se a pele parece real, o rosto vem junto.
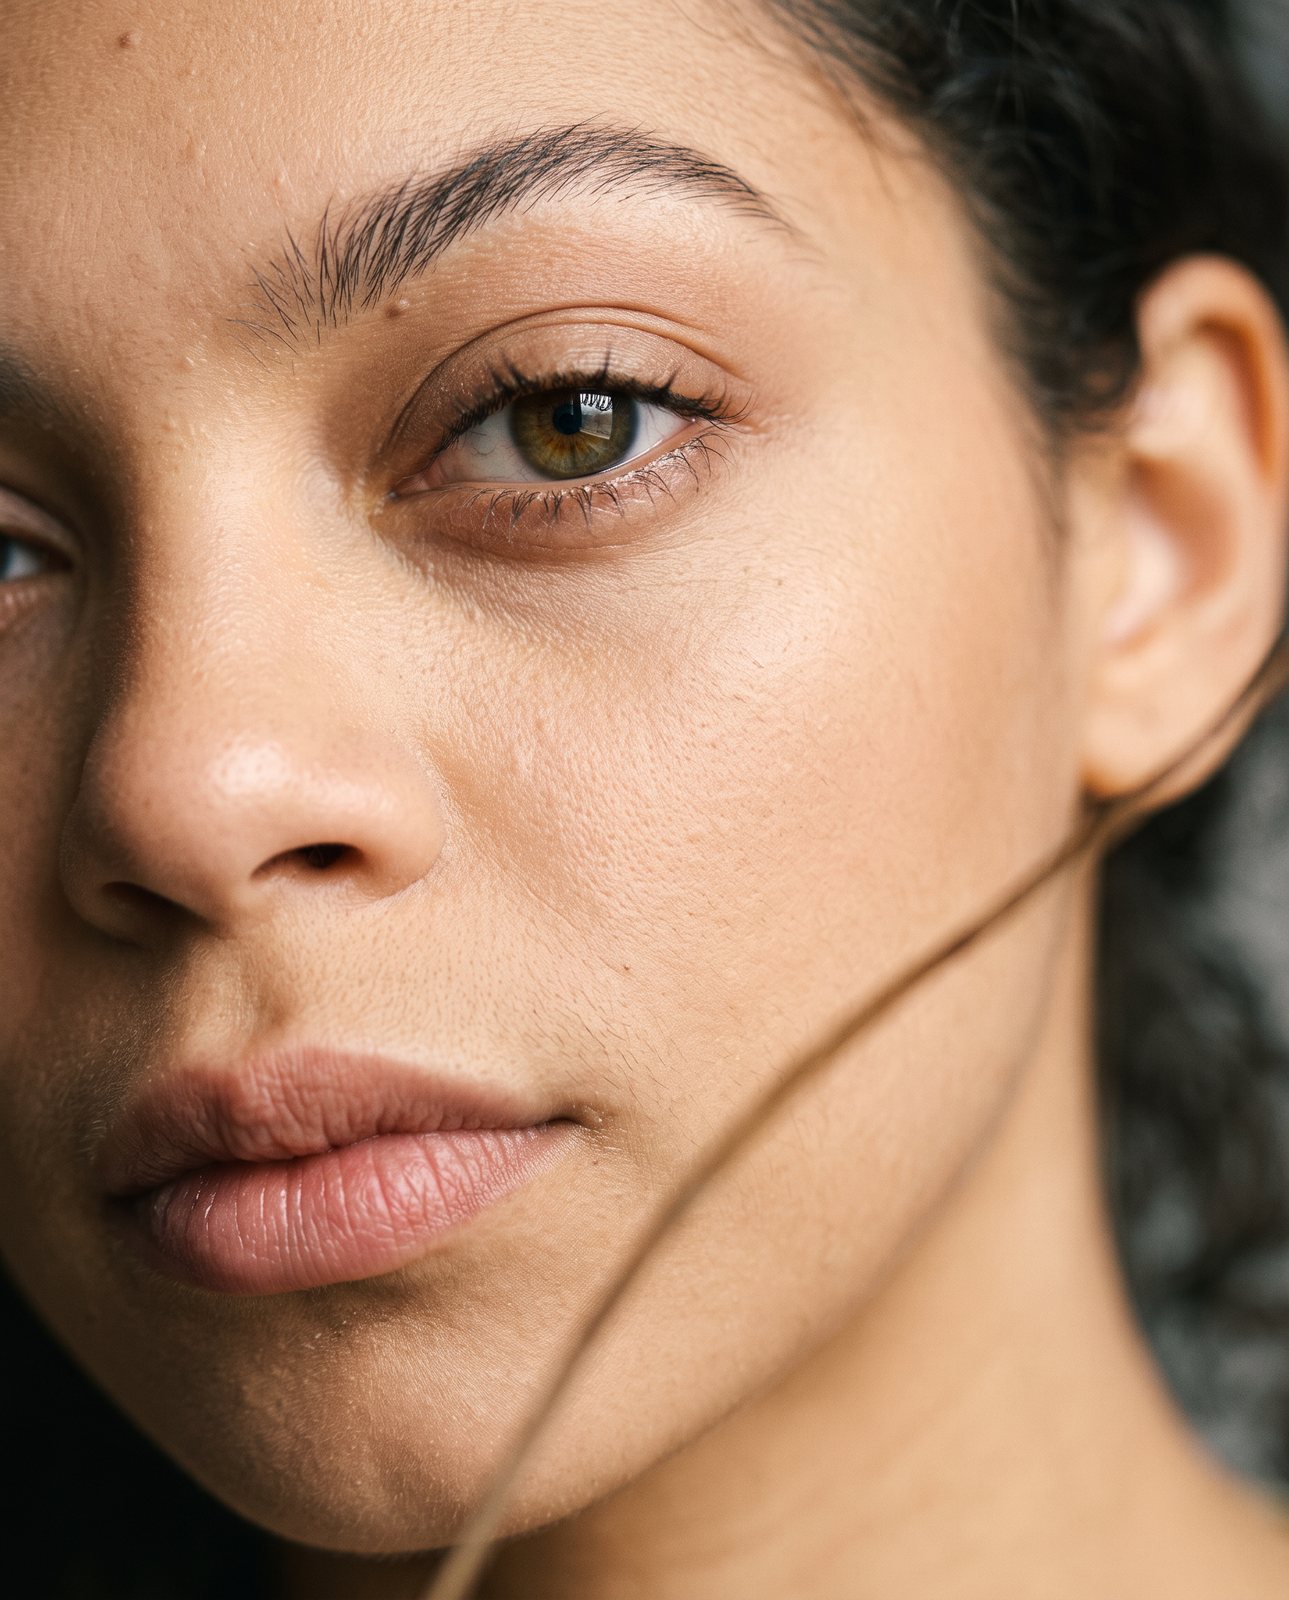
Ainda quero testar o quanto da fidelidade vem da foto de referência e o quanto vem dessa descrição. Em quatro das sete fichas a modelo era chamada direto pela referência; nas outras três, só pela pose e pela situação.
O que fazer quando a IA insiste num erro?
Corrigir só aquele ponto. No Baw®, o character sheet pedia um rosto sem barba, mas a IA colocou bigode em 8 das 10 imagens. Gerar tudo de novo arriscaria perder luz, pose e figurino que já estavam certos. A correção foi um retoque cirúrgico em cada uma: tirar só o bigode e preservar geometria do rosto, expressão, poros, luz, grão e o logo do moletom.
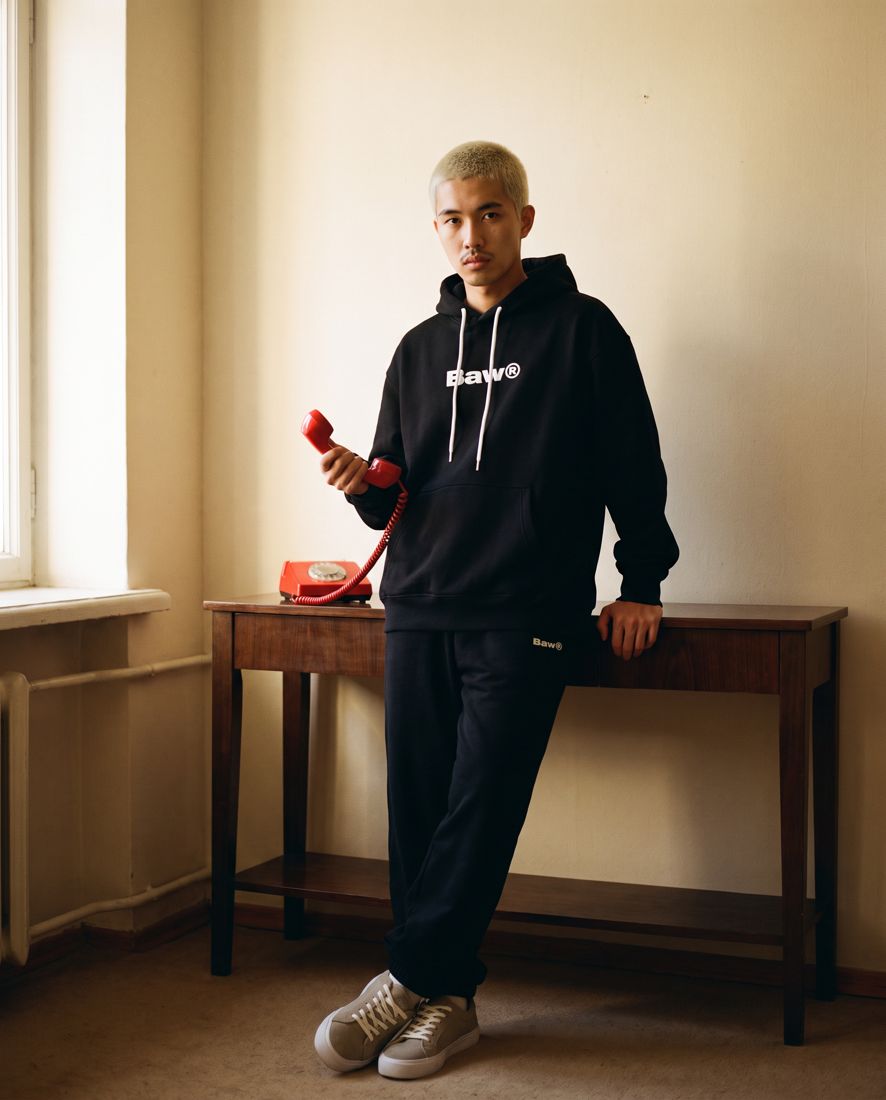
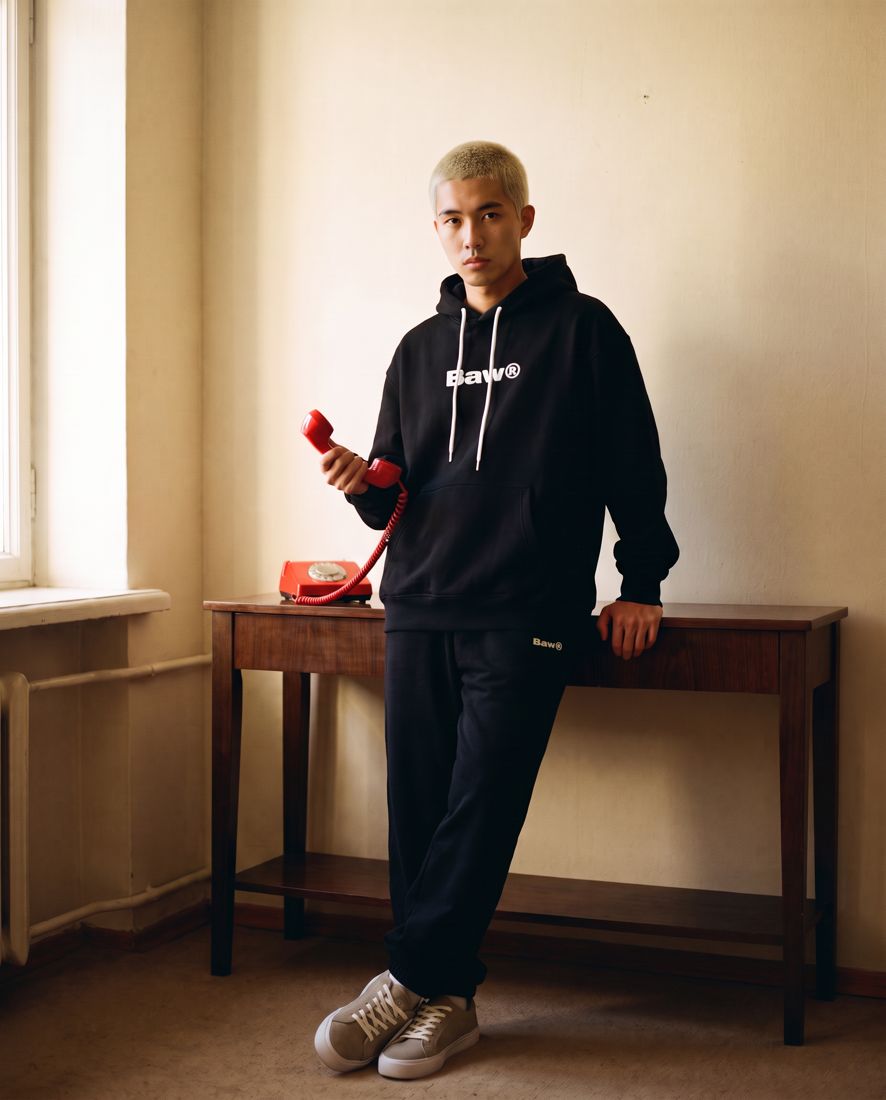
Arraste para comparar. A IA leu bigode onde não tinha em 8 das 10 imagens.
Esse tipo de edição local é justamente um dos pontos fortes que o Google destaca no Gemini: pedir uma mudança específica em linguagem simples, sem refazer a cena inteira.
Uma cena precisou ser refeita: o rosto perdeu o queixo fino e envelheceu. Na revisão, usei uma das imagens já aprovadas como segunda referência de identidade e deixei a atmosfera em segundo plano. A ordem de prioridade passou a ser identidade antes de cena e luz.
A ferramenta faz diferença?
Faz, e mais do que eu esperava. No 90s Nostalgia, fiz tudo no Seedream 5.0 Lite, um modelo de entrada, de propósito. A consistência foi maior do que eu imaginava: os personagens se mantiveram estáveis entre cenas e combinações.
Mas ele também perdeu o controle em alguns testes. Criou expressões deformadas, colocou pessoas novas na cena quando o pedido era só mudar a pose de alguém, e ajustes que deveriam mexer só na luz mudavam o próprio personagem.
No fim, levei os mesmos personagens e prompts para o Nano Banana, e as mesmas instruções geraram personagens e cenas completamente diferentes. O prompt não existe separado da ferramenta. Escolher o modelo também é uma decisão criativa.
As ferramentas também estão mudando rápido. O Nano Banana 2, lançado pelo Google em fevereiro de 2026, promete manter a semelhança de até cinco personagens e a fidelidade de até 14 objetos num mesmo fluxo. No Midjourney, a referência de personagem da versão 6 foi substituída pela Omni Reference na versão 7. Vale testar de novo a cada versão.
Resumo: o passo a passo
- Crie ou escolha a pessoa antes de pensar nas cenas.
- Monte uma prancha de referência: rosto de frente, três quartos e perfil, e corpo, se for aparecer.
- Separe as referências: uma prancha para o rosto, outra para a roupa ou o produto.
- Escreva no prompt o que não pode mudar, incluindo a textura da pele.
- Varie à vontade cenário, luz e câmera, e descreva tudo isso numa ficha antes de gerar.
- Quando a IA errar um detalhe, corrija só aquele ponto.
- Se o rosto se perder numa cena, use uma imagem já aprovada como segunda referência.
- Teste a mesma ficha em mais de uma ferramenta antes de começar o ensaio.
Para uma marca, consistência de personagem não é detalhe técnico. É o que permite usar IA numa campanha sem que a pessoa vire outra no terceiro post.
O trabalho de direção continua o mesmo de um set: decidir câmera, luz e acabamento para cada cena. A diferença é que tudo isso precisa estar escrito antes, porque a ficha é o set.
Veja os cases completos: Baw® · Um retrato, sete sets · 90s Nostalgia
Precisa de um ensaio com o mesmo rosto do início ao fim? Veja os serviços ou manda o briefing.
Leia também: Como manter o produto idêntico em todas as cenas com IA
Para ler mais
Google, Tips for getting the best image generation and editing in the Gemini app (Naina Raisinghani, 26 ago 2025). Disponível em: https://blog.google/products/gemini/image-generation-prompting-tips/
Google, Nano Banana 2: Combining Pro capabilities with lightning-fast speed (26 fev 2026). Disponível em: https://blog.google/innovation-and-ai/technology/ai/nano-banana-2/
Midjourney, Character Reference. Disponível em: https://docs.midjourney.com/docs/character-reference
Ruiz et al., DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven Generation, Google Research (2022). Disponível em: https://arxiv.org/abs/2208.12242